martes, 12 de octubre de 2010

Ubuntu Enterprise Cloud 10.10

Ubuntu

Muchos han sido los artículos publicados el día 10 junto con la publicación de Ubuntu Maverick Meerkat (10.10) pero también junto con la versión del escritorio tenemos la versión de servidor destinada a empresas aunque para un entorno de producción es más recomendable usar la versión LTS (10.04) por el mayor tiempo de soporte que posee. Además de la tradicional versión para instalar como servidor también se puede instalar para construir una nube (que tan de moda está) privada o en una nube pública utilizando los recursos de la nube de Amazon.

La Ubuntu Enterprise Cloud (UEC) está formado por un controlador de la nube y uno o varios nodos controladores de las instancias. La nube de Ubuntu se basa en el software Eucalyptus.

El proceso de instalación de una nube privada de Ubuntu se inicia como cualquier instalación de otro sistema operativo introduciendo el CD o mediante una memoria USB (para hacer las pruebas lo más recomendables es utilizar una máquina virtual como Vitrtualbox u otras similares).


Una vez iniciamos el sistema seleccionaremos el lenguaje de la instalación y en vez de seleccionar la opción «Instalar Ubuntu Server» seleccionamos «Instalar Ubuntu Enterprise Cloud», los pasos para completar la instalación son similares a los pasos de instalación de un servidor normal, seleccionaremos el particionado de los discos, la distribución del teclado, el usuario y contraseña para el usuario root, se descargan algunos paquetes, etc... Una vez haya finalizado la instalación y se haya reiniciado el sistema podremos acceder a la consola de administración del nodo controlador de la nube. Para ello tendremos que conocer su dirección IP, lo podemos saber iniciado sesión en el servidor y ejecutando el comando:

$ ifconfig | more

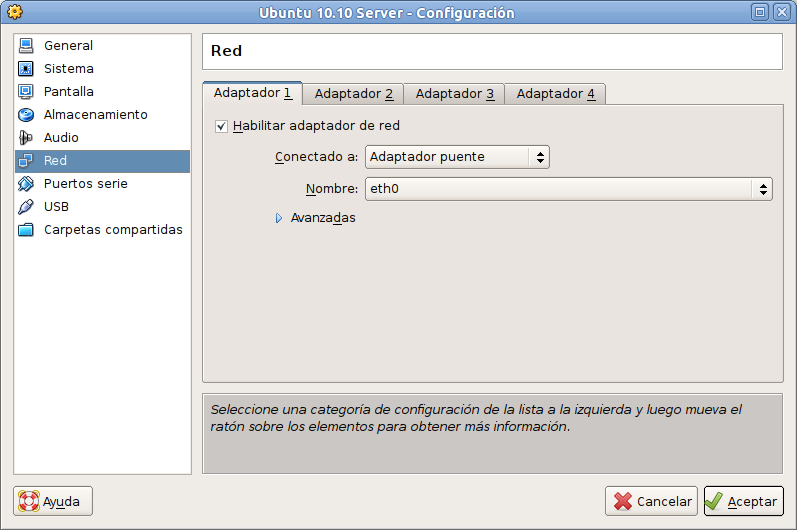
Nos fijaremos en el campo «Direc. inet» de la interfaz br0 si como yo lo estáis probando en una máquina virtual de Virtualbox con una red no NAT sino adaptador puente (no la por defecto NAT).

Una vez conocida la dirección IP abriremos el navegador, la introduciremos en la barra de direcciones y accederemos a la consola de administración donde podremos ver algunos de los parámetros de la nube que estamos creando. El usuario y contraseña por defecto para acceder a la consola de administración es «admin» tanto para el usuario como para la contraseña. Estas son algunas capturas de las opciones de la consola de administración.


En la pestaña Store podremos seleccionar las imágenes que queremos instalar y en las que se instalarán los servicios que propocionará nuestra nube. También podremos subir nuevas imágenes a la nube para servicios personalizados.


Una vez hayamos instalado correctamente una imagen procederemos a iniciarla desde el controlador de la nube, iniciamos sesión en el y lo primero que haremos será obtener las credenciales con:

$ mkdir -p ~/.euca
$ chmod 700 ~/.euca
$ cd ~/.euca
$ sudo euca_conf --get-credentials mycreds.zip
$ unzip mycreds.zip
$ ln -s ~/.euca/eucarc ~/.eucarc
$ cd -

Ahora generaremos la clave privada con un pequeño script con el siguiente contenido:

if [ ! -e ~/.euca/mykey.priv ]; then
    mkdir -p -m 700 ~/.euca
    touch ~/.euca/mykey.priv
    chmod 0600 ~/.euca/mykey.priv
    euca-add-keypair mykey > ~/.euca/mykey.priv
fi


Permitimos el acceso mediante SSH a las instancias que es como nos conectaremos a la consola de cada una de ellas:

$ euca-authorize default -P tcp -p 22 -s 0.0.0.0/0

Arrancaremos una instancia con:

euca-run-instances $EMI -k mykey -t m1.small


Donde $EMI lo sustituiremos por el Id de una imagen de la pestaña Images. En mi caso el Id del emi asignado es «emi-DF56106F».

Cuando la instancia este arrancada nos podremos conectar a ella con:

$ EMI=emi-DF56106F
$ IPADDR=$(euca-describe-instances | grep $EMI | grep running | tail -n1 | awk '{print $4}')
$ ssh -i ~/.euca/mykey.priv ubuntu@$IPADDR

Para parar la instancia usamos el comando:

$ EMI=emi-DF56106F
$ INSTANCEID=$(euca-describe-instances | grep $EMI | grep running | tail -n1 | awk '{print $2}')
$ euca-terminate-instances $INSTANCEID

Si estamos probando Ubuntu Enterprise Cloud en una máquina virtual como Virtualbox y reiniciamos la máquina virtual deberemos modificar el archivo ./.euca/.eucarc y las variables S3_URL y EC2_URL con la nueva IP que se le asigne a la máquina que será la misma que hemos obtenido con el comand if config de unos cuantos pasos antes. Una vez modificado el archivo ejecutamos los siguiente para recargar las variables:

$ . ~/.euca/eucarc


O le cambiamos a la interfaz de red la IP a la que tiene el archivo ./.euca/.eucarc con el comando:

$ ifconfig br0 85.84.32.71

Referencia:
http://www.ubuntu.com/cloud
https://help.ubuntu.com/community/UEC
https://help.ubuntu.com/community/UEC/CDInstall
http://www.eucalyptus.com/
Eucalyptus beginners guide
5 opciones de hosting para aplicaciones Java

viernes, 1 de octubre de 2010

Instalar la Ubuntu font en Arch Linux

Dentro de unos días será publicado la versión 10.10 de Ubuntu conocida como Maverick Meerkat. Una de las novedades más visibles de cara al usuario será la incorporación del la fuente llamada Ubuntu font. Esta fuente destaca por sus formas simples y por su fácil lectura.

Pero los usuarios de Arch Linux también podemos disfrutar de ella. Basta con instalar el paquete ttf-ubuntu-family-fonts del repositorio AUR y cambiar la fuente en Sistema > Preferencias > Apariencia > Tipografías.
$ yaourt -S ttf-ubuntu-font-family

La página oficial de Ubuntu hace uso de ella así que si quieres echarle un vistazo sin instalar nada pasate por la página de Ubuntu o haz click en una de las capturas de pantalla que adjunto.

Captura usando la fuente Ubuntu

GNOME 2.32 publicado, rumbo a GNOME 3.0


La versión 2.32 del entorno de escritorio GNOME ha sido publicada hace unos pocos días. Las novedades que incorpora no son tan numerosas como en versiones anteriores ya que los desarrolladores se están centrando en la siguiente revisión mayor de este entorno de escritorio, la versión 3.0, a ser publicada según su calendario el 6 de abril si todo va vien y no hay nuevos retrasos. Esto es lo que nos espera en la versión 3.0.


Pero de momento toca disfrutar de la 2.32. En las notas de publicación puedes encontrar las modificaciones más relevantes realizadas.

Para los usuarios de Arch Linux no tadará en estar disponible en los respositorios para actualizarse y los usuarios de Ubuntu podrán disfrutarla el día 10.10.10, ¡ya solo quedan unos pocos días de espera!.

viernes, 27 de agosto de 2010

Copiar archivos desde y a un dispositivo bluetooth

Bluetooth

Hay que reconocerlo, a veces las cosas en Linux no funcionan sin más y hay que emplear alguna artimaña para conseguir lo que queremos. Estoy hablando, en mi caso, sobre el copiar archivos desde y a un dispositivo bluetooth como por ejemplo un móvil. Por alguna razón el examinar archivos y enviar archivos utilizando el icono del bluetooth que proporciana GNOME normalmente me falla quedándose las operaciones que le pido que haga bloqueadas al inicio de la operación.

Sin embargo, si a alguien le pasa lo mismo quizá no este todo perdido y la siguiente forma que voy a explicar a continuación le funcione. La forma con la que he conseguido copiar archivos con un dispositivo bluetooth es utilizando el comando obexfs. Este comando lo que hace básicamente es montar el sistema de archivos del dispositivo bluetooth en una carpeta del sistema de archivos de nuestra computadora donde posteriormente podremos hacer las operaciones tal y como si estuviésemos trabajando con los archivos de nuestro disco duro, por ejemplo utilizando el navegador de archivos nautilus.

Para instalarlo ejecutamos el comando:

$ sudo pacman -S obexfs

Para montar el sistema de archivos del dispositivo bluetooth ejecutamos:

$ obexfs -b [dirección dispositivo bluetooth] [carpeta montaje]

Con el siguiente comando se puede montar el sistema de archivos de un dispositivo bluetooth en una carpeta en el escritorio:

$ obexfs -b 00:1C:9A:42:25:BE ~/Desktop/movil

La dirección del dispositivo bluetooth (en mi caso 00:1C:9A:42:25:BE) la podéis obtener usando el comando hcitool mediante (recordad configurar el dispositivo bluetooth en modo visible e instalar el comando si no lo tenéis):

$ hcitool scan

Cuando terminemos de copiar archivos mediante nautilus podemos desmontar el sistema de archivos del dispositivo bluetooth con:

$ sudo umount ~/Desktop/movil

Utilización del comando obexfs
Enlaces:
Arch Linux wiki bluetooth

miércoles, 18 de agosto de 2010

Programación orientada a aspectos con la clase Proxy

Java

La programación orientada aspectos (AOP) es uno de los conceptos que en estos días se usa muy habitualmente en el desarrollo de aplicaciones Java. Básicamente, nos permite separar cierta lógica de soporte de la lógica propia de la aplicación, por ejemplo, se puede utilizar si necesitamos medir el tiempo que tarda en ejecutarse un determinado método, cuantas veces se llama, sacar trazas, aplicar seguridad, obtener conexiones a base de datos, gestionar la transaccionalidad, etc... En vez de añadir el código de estas funcionalidades a las clases de nuesta aplicación lo podemos añadir a una clase que se encarge de implementar el aspecto.

La librería Spring proporciona un amplio soporte para la programación orientada a aspectos, sin embargo, hay veces en el que no tenemos control sobre las librerías que podemos utilizar en nuestro proyecto. En este caso nos tenemos que limitar a lo que nos proporciona el propio JDK.

A pesar de que hoy el concepto es muy conocido se puede venir haciendo desde el JDK 1.3 (desde el año 2000) a través de la clase Proxy y su uso es realmente sencillo para las ventajas que aporta al código de una aplicación.

Supongamos que necesitamos medir cuanto tiempo tardan en ejecutarse los métodos de un determinado objeto (en realidad de una interfaz). En vez de calcular el tiempo dentro de la propia clase que queremos medir podemos implementarlo mediante un aspecto con la clase Proxy de la siguiente forma (el método main no es realmente necesario solo está incluido para hacer simple el probar el ejemplo):

import java.lang.reflect.InvocationHandler;
import java.lang.reflect.Method;
import java.lang.reflect.Proxy;
import java.util.Date;
import java.util.HashSet;
import java.util.Set;
import java.util.TreeSet;

public class ProfileProxy implements InvocationHandler {

    protected Object object;
    protected Proxy proxy;

    public ProfileProxy(Object object) {
        this.object = object;
        // Creación del proxy que intercepta las llamadas a los métodos del objeto
        proxy = (Proxy) roxy.newProxyInstance(object.getClass().getClassLoader(), object.getClass().getInterfaces(), this);
    }

    public Proxy getProxy() {
        return proxy;
    }

    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        long start = new Date().getTime();
            
        // Invocar al servicio
        Object o = method.invoke(object, args);
            
        long end = new Date().getTime();
        System.out.println("Tiempo: " + (end - start) + "ms");
        
        return o;
    }
    
    public static void main(String[] args) throws Exception {
        Set data = new HashSet(); 
        for (int i = 0; i < 100000; ++i) {
            data.add(new Integer((int) (Math.random() * 100000)));
        }
        
        HashSet hashSet  = new HashSet();
        TreeSet treeSet  = new TreeSet();
        
        Set proxyHashSet  = (Set) new ProfileProxy(hashSet).getProxy();
        Set proxyTreeSet  = (Set) new ProfileProxy(treeSet).getProxy();
        
        proxyHashSet.addAll(data);
        proxyTreeSet.addAll(data);
    }
}


El método main del ejempo trata de medir cuanto tiempo se tarda en añadir los elementos de un Set a otro para un HashSet y para un TreeSet. Dado que la clase TreeSet mantiene los elementos ordenados según su orden natural es de esperar que tarde más tiempo.

En mi equipo añadir cien mil elementos de un Set a un HashSet tarda 62ms y añadir el mismo número de elementos a un TreeSet 110ms.

Pero todo no son cosas buenas, una pequeña limitación de utilizar la clase Proxy es que la interceptación de las llamadas se tienen que hacer sobre los métodos de una interfaz que implemente el objeto.

viernes, 13 de agosto de 2010

Lenguajes de scripting sobre la plataforma Java

Java Groovy JythonClojure JRuby

Desde la versión del JDK 6 es posible utilizar lenguajes de scripting dentro de la máquina vitual Java. Con lo que a además de Java podemos utilizar otros lenguajes como AspectJ, ColdFusion, Clojure, Groovy, JavaFX, JRuby, Jython, Rhino o Scala y algunos otros más. Por defecto, solo Rhino viene incluido en el JDK. La ventaja de estos lenguajes de scripting es que pueden ser más adecuados para ciertas tareas que el propio Java.

De entre estos lenguajes destaca Groovy al tener una sintaxis similar a Java (que lo hace la opción natural para los propios programadores Java), ser completamente orientado a objetos (los tipos primitivos de Java se tratan como objetos), tener una sintaxis más compacta que Java (los punto y coma de final de sentencia son opcionales y en algunos casos los paréntesis), tener una sintaxis nativa para listas, mapas y expresiones regulares (que es muy útil ya que son tipos de datos que se utilizan mucho en todos los programas), integración bidireccional con Java (las clases de Java se pueden utilizar en clases Groovy y las clases de Groovy se pueden utilizar desde Java), soportar closures, propiedades y sobrecarga de operadores.

Podemos ver los lenguajes de scripting que soporta nuestro JDK con:


$JAVA_HOME/bin/jrunscript -q


Para evaluar una expresión de un lenguage de scripting podemos utilizar el comando jrunscript del JDK, en el caso de ejemplo se ejecuta una expresión Groovy que imprime una cuenta de 1 a 10.


$JAVA_HOME/bin/jrunscript -cp
$GROOVY_HOME/embeddable/groovy-all-1.7.4.jar -l groovy -e "10.times {
println it }"


Si queremos evaluar expresiones Groovy desde un programa Java lo podemos hacer con la clase GroovyShell proporcionada por la librería groovy-all-1.7.4.jar:


import groovy.lang.GroovyShell;

public class GroovyTest {
    public static void main(String[] args) {
        GroovyShell shell = new GroovyShell();
        shell.evaluate("10.times { println it }");
    }
}


Sin embargo no es la única forma de evaluar un expresión de un lenguaje de scripting desde Java también podemos hacerlo de una forma más estandar con las clases del JDK 6:


import javax.script.ScriptEngine;
import javax.script.ScriptEngineManager;

public class GroovyTest {
    public static void main(String[] args) throws Exception {
        ScriptEngineManager manager = new ScriptEngineManager();
        ScriptEngine engine = manager.getEngineByName("groovy");
        engine.eval("10.times { println it }");
    }
}


Hay alguna forma más de evaluar expresiones y scripts, sin embargo, cada una tiene ciertas ventajas y desventajas sobre las otras, por lo que deberemos decidir cual es la más adecuada para nuestro caso.

Pero... ¿Como se añaden nuevos lenguajes de scripting al JDK? Pues es bastante simple, en el caso de Groovy basta con copiar la libreria groovy-all-1.7.4.jar al directorio $JAVA_HOME/jre/lib/ext o añadirla al classpath cuando ejecutemos una aplicación.  Si ejecutamos ahora el comando jrunscript para ver que lenguajes de scripting soporta nuestra JVM veremos que se devuelven dos lenguages, Rhino que viene por defecto en el JDK y Groovy que lo acabamos de añadir. Para otros lenguages de scripting el proceso es parecido.


Para ciertas tareas utlizar alguno de estos lenguajes puede ser más adecuado, se me ocurre el caso de tener que hacer un determinado cálculo que previsiblemente puede variar en un futuro. En vez de implementarlo en Java lo que nos obligaría a tener que volver a compilar el programa y volverlo a arrancar se puede realizar con uno de estos lenguajes y guardarlo en base de datos o en un fichero, con lo que podría ser muy fácilmente actualizable y sin necesidad de tener que compilar ni parar la aplicación lo que proporciona agilidad a la hora de implementar cambios. En definitiva los lenguajes de scripting añaden nuevas posibilidades a la plataforma Java.

Referncia:

martes, 3 de agosto de 2010

Firebug, revisión de la traducción al español completada

Una de las extensiones de Firefox que uso habitualmente es Firebug para el desarrollo de aplicaciones web ya que tiene un montón de funcionalidades útiles. Sin embargo, la traducción que existe hasta ahora para la versión 1.5.4 de Firebug deja bastante que desear. Tiene bastantes cadenas sin traducir y no sigue las convenciones de traducción del español, por ejemplo, poniendo la primera letra de cada palabra en mayúsculas lo que dificulta la lectura de los textos ya que los hispanohablantes estamos más acostubrados a poner los textos sin capitalizar cada palabra.

Además, la traducción al español estaba disponible únicamente para las regiones es-ES (España), es-AR (Argentina) y es-CL (Chile). A partir de ahora la región «es-ES» se ha sustituido por la más general «es» con lo que espero haga disponible la traducción para el resto de regiones que no tienen la traducción realizada, como «es-MX» (México), etc...

La versión de Firebug 1.6 está apunto de ser liberada y se espera que se produzca a mediados de este mes de agosto. Como comento, me he puesto manos a la obra y he revisado por completo la traducción al español de este plugin para Firefox en unas pocas horas. Espero que a partir de la versión 1.6 a los que lo usen habitualmente les resulte más comodo trabajar con él.

Esta pequeña aportación al software libre se suma a la de otros programas de los cuales ya mantengo sus traducciones (Oracle VM Virtualbox y VLC). Desde aquí animar a que si alguien usa habitualmente un programa de software libre que no esta traducido o la traducción de su idioma no es del todo correcta, y quiere aportar su granito de arena devolviendo un poco del amor que el programa le dió, se informe de como se ha de realizar la traducción para ese programa, se ponga en contacto con el proyecto o actual mantenedor del idioma y realice o complete la traducción.

Nunca hubiese imaginado que colaborar con el software libre fuese tan sencillo, lo único realmente necesario para tareas de traducción es un poco de tiempo, seguir una serie de conveciones en la traducción y saber un poco de inglés (no hace falta ser programador, aunque en algunas cosas ayuda).