viernes, 24 de junio de 2011

Hola mundo con Symfony 2 y Cherokee

Symfony
Cherokee
Después de las entradas de Servidor web ligero Cherokee, instalación e integración con PHP en Arch Linux y de como Instalar Symfony y Cherokee en Arch Linux iba a ponerme a escribir una entrada con un Hola mundo para Symfony pero la verdad es que no creo que merezca la pena ya que la documentación de Symfony me parece tan buena que prácticamente sería repetir lo que pone en ella. Me limitaré a explicar como configurar las reglas de Cherokee para que las rutas de la apliación de Symfony sean más amigables de SEO, esto es, sin que incluyan la ruta al controlador frontal (/app_dev.php). Aunque esto también está explicado para Symfony 1 en un Cookbook de Cherokee.

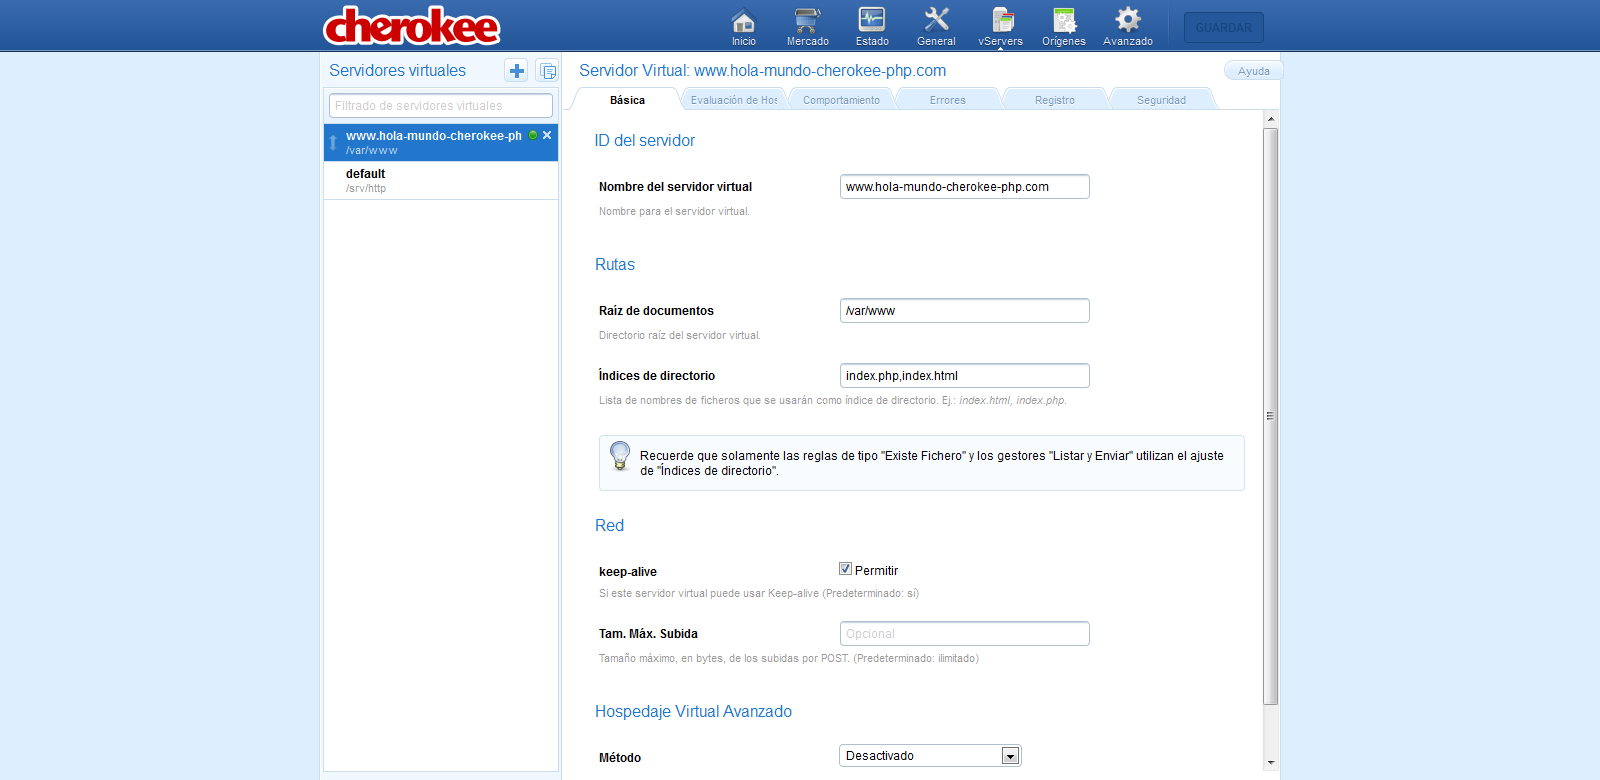
Teniendo instalado el soporte para PHP y Symfony en Cherokee de las dos entradas anteriores empezaremos modificando en la pestaña «Básica» la propiedad Raiz de documentos de «/var/www» a «/var/www/Symfony/web» del servidor virtual.

Inicialmente en la pestaña «Comportamiento», donde veremos las acciones que realizará Cherokee según la URL recibida, tendremos dos reglas «Extensions PHP» y «Por defecto», la primera se encargará de capturar las URL que deban ser tratadas por el preprocesador de PHP y la segunda de devolver un listado en caso de que se pida un directorio o de devolver un archivo, por ejemplo una imagen o una hoja de estilo. Ahora en la pestaña «Comportamiento», añadiremos una regla «Existe fichero» seleccionando en el asistente la opción «Coincide cualquier fichero». Con esta regla se devolverá el contenido estático de nuestra aplicación.

Si queremos que en los listados de directorios aparezcan bien los estilos e imágenes tendremos que copiar las reglas «/cherokee_themes» y «/icons» del sevidor virtual default con el mismo contenido en las pestañas «Regla» y «Gestor».

Finalmente modificamos la regla «Por defecto» que será la que redirija las peticiones al controlador frontal para ello modificamos la regla en la pestaña «Gestor» indicando que ahora será de tipo «Redirección», en la lista de reglas añadiremos dos reglas de tipo Interna con el mismo contenido que se ve en la imagen (^(.*)$ -> /app_dev.php, ^/$ -> /app_dev.php).

Las reglas tienen que estar en un orden concreto, ya que son procesadas por Cherokee en ese orden, para cambiarlo se puede utilizar arrastrar y soltar. El orden final sería Extensions php, Existe fichero, Directorio /cherokee_themes, /icons y Redirección.


A veces la aplicación de administración de Cherokee no hace correctamente los cambios en el archivo de configuración /etc/cherokee/cherokee.conf y tal vez nos toque editarlo directamente en el archivo.

Referencia:
http://symfony.com/
http://symfony.com/doc/current/book/page_creation.html#application-configuration
http://www.cherokee-project.com/doc/cookbook_symfony.html

Servidor web ligero Cherokee, instalación e integración con PHP en Arch Linux
Instalar Symfony y Cherokee en Arch Linux

viernes, 17 de junio de 2011

Instalar Symfony y Cherokee en Arch Linux

Symfony
Cherokee
El lenguaje de programación PHP es uno de los más usados para desarrollar sitios web de internet. Su popularidad se debe a su sencillez y su clara orientación al mundo de las páginas web. Es un lenguaje de scripting que ha incoporado y mejorado el soporte para la orientación a objetos en las últimas versiones, yendo de esta forma hacia la dirección que en estos tiempos han seguido la mayoría de lenguajes. Para proyectos pequeños y sencillos usar únicamente scripts de PHP puede ser suficiente pero en cuanto la complejidad y tamaño del proyecto aumenta es necesario buscar soluciones para que el desarrollo y mantenimiento posterior no se convierta en un infierno, en la web de Symfony tienen un excelente artículo de por que son necesarios y con estos motivos surgen los frameworks. En PHP en concreto hay varios disponibles, quiza los más conocidos sean: Zend, Prado, Yii y Symfony aunque hay otros.

En esta entrada vamos a ver como instalar y configurar uno de ellos, Symfony 2 que sigue el tradicional modelo MVC y que nos va a proporcionar las facilidades necesarias para los tipos de proyectos más habituales. Antes de poder utilizarlo necesitaremos un servidor web con soporte para interpretar PHP. En esta otra entrada puedes ver como instalar un servidor web Cherokee con PHP en Arch Linux.

Lo primero que necesitaremos será descargar el paquete del framework Symfony para ello nos dirigimos a la página de descarga del proyecto y elegimos descargar la versión que incluye los «vendors». Una vez descargado crearemos un servidor virtual para la aplicación, para ello arrancamos el servidor de administración de cherokee con el siguiente comando e introducimos http://localhost:9090 en nuestro navegador favorito:

$ sudo cherokee-admin -b -u

Crearemos un servidor con soporte para PHP desde el apartado vServers. Una vez hayamos introducido los datos básicos que nos pide el asistente crearemos dos reglas para servir el contenido estático necesario para mostrar los estilos e imagenes corretamente cuando cherokee muestra un listado de archivos. Para ello vamos a la pestaña Comportamiento del servidor virtual y creamos las reglas para /cherokee_themes y /icons, para crearlas nos podemos fijar en como están en servidor virtual por defecto y las copiaremos con el mismo contenido.


Ahora descomprimiremos el paquete de Symfony y copiamos la carpeta raiz Symfony a /var/www/ para que el servidor web pueda ejecutar la aplicación. Una vez lo hayamos hecho accederemos a http://localhost/Symfony/app/config.php con el navegador en la que Symfony comprobará el estado de la instalación mostrándonos los errores y las recomendaciones que nos hace. Para solventarlos todos deberemos instalar los siguientes paquetes:

$ yaourt -S php-gd php-apc php-intl php-sqlite

Además deberemos cambiar los permisos a carpetas para Symfony pueda trabajar:

$ sudo chmod 775 -R /var/www/Symfony/app/cache/
$ sudo chmod 775 -R /var/www/Symfony/app/logs/

A continuación deberemos modificar el archivo de configuración de php (/etc/php/php.ini) añadiendo a la variable open_basedir lo siguiente:

open_basedir = /srv/http/:/home/:/tmp/:/usr/share/pear/:/var/www/:/usr/:/bin/:/sbin/

También modificaremos la variable date.timezone a la correspondiente a nuestra zona horaria:

date.timezone = Europe/Madrid

Además en el apartado de extensiones del archivo php.ini descomentaremos las siguientes:

extension=apc.so
extension=iconv.so
extension=intl.so
extension=json.so
extension=mysqli.so
extension=pdo_sqlite.so
extension=posix.so
extension=sqlite3.so

Tras estas modificaciones la página http://localhost/Symfony/app/config.php nos indicará que nos nos queda nada pendiente por hacer y podremos pulsar en el enlace «Configure your Symfony Application online» que nos permitirá configurar la base de datos que utilizaremos entre otras cosas básicas. Ya estamos listos para ir a la página de inicio que tenemos por el momento en la aplicación http://localhost/Symfony/web/app_dev.php/.


Ya solo nos queda empezar a desarrollar algo, pero eso quizá sea tema para otra entrada.

Referencia:
http://symfony.com/
http://symfony.com/doc/current/
http://elblogdepicodev.blogspot.com/2011/05/servidor-web-ligero-cherokee.html

jueves, 9 de junio de 2011

Elegir herramientas para un proyecto Java

Java
Cuando empezamos un nuevo proyecto siempre tenemos que tomar decisiones en el aspecto técnico eligiendo las herramientas que vamos a usar para desarrollar el proyecto. La selección adecuada de estas herramientas puede determinar en gran medida lo fácil que pueda resultar el mantenimiento del mismo que en muchos proyectos es la parte a la que más tiempo se le suele dedicar. El elegir la herramienta adecuada no es una decisión fácil ya que hay muchos lenguajes que podríamos utilizar, para cada lenguaje numerosos frameworks y para algunas tareas específicas como acceso a base de datos o generación de informes varias librerias. La decisión de cual elegir es un poco subjetiva según las preferencias de cada uno pero hay varios factores que pude ayudarnos como los conocimientos que tenga el equipo que lo va a desarrollar o las limitaciones impuestas por el mismo proyecto o cliente. Pero si tuviesemos una carta blanca y pudiesemos elegir libremente ¿cuales son las herramientas que utilizaríamos?

Independientemente del tipo del proyecto hay ciertas categorías de herramientas comunes a todos los proyectos para cada una de las cuales deberíamos elegir una. Estas serían:

Herramienta control de versiones: Esta es una herramienta imprescindible si son varias las personas que participan en el proyecto ya que permite compartir a todos los integrantes del mismo el código fuente de una forma rápida y cómoda. Y aún trabajando solo en el proyecto una herramienta de este tipo nos permite almacenar un historial de todos los cambios que hemos ido realizando al código fuente por si necesitamos recuperar alguna parte en algún momento además de etiquetar ciertas versiones para igualmente poder recuperarlas si es necesario. En estos momentos Subversion y Git son dos de las herramientas más conocidas y utilizadas. La principal diferencia entre ellas es que Subversion utiliza un modelo cliente/servidor y Git utiliza un modelo distribuido. Git sería la opción que elegiría por ser la evolución que están tomando estas herramientas y por tener algunas ventajas sobre Subversion como la mayor facilidad para crear branches.

Herramienta gestión de peticiones: Habiendo trabajado con un herramienta de este tipo uno piensa como era posible trabajar sin una y es que permite conocer a todos los miembros de equipo las tareas que están pendientes de realizar, que está haciendo cada uno y cual es el progreso de las mismas y su estado evitando que se «pierdan». Además pueden integrase con el sistema de control de versiones permitiendo anotar en los tickets referencias a una revisión del código fuente y ver que cambios tiene cada petición cosa que puede implicar varios commits en la herramienta de control de versiones. Tenemos a disposición varias herramientas (bugzilla, Mantis, ...) pero de las que he visto Trac y Redmine (por tener ambas una wiki que permite anotar documentación) son las que más me han gustado.

Herramienta de construcción del proyecto: Si queremos trabajar de forma cómoda y no perder el tiempo realizando tareas repetitivas necesitamos una herramienta que nos automatice la tarea de compilar el proyecto y desplegarlo en el servidor asi como de ejecutar las pruebas unitarias. Herramientas específicas para este propósito son Ant, Maven y por la que yo optaría si pudiese elegir sería Gradle.

Herramienta de pruebas unitarias: Si queremos asegurarnos de que las cosas hacen lo que tienen que hacer deberíamos desarrollar junto con nuestro código fuente sus pruebas unitarias. Además estas mismas pruebas nos servirán para comprobar si las cosas siguen funcionando después de un determinado cambio. Herramientas de pruebas hay muchas pero varias de ellas son JUnit, Mockito, PMD, Checkstyle y Selenium.

Herramienta de integración continua: Las herramientas de integración continua permite realizar ciertas tareas cada cierto tiempo de forma automática y se suelen utilizar para comprobar que el proyecto sigue compilando correctamente con los cambios que se van haciendo en la herramienta de control de versiones, para comprobar que siguen pasando las pruebas unitarias y para construir una versión a ser desplegada en los servidores. Quizá la más conocida y utilizada en estos momentos es Jenkins. Uno de sus puntos fuertes es su extensibilidad a través de plugins.

Después de estas herramientas comunes a todos los proyectos deberemos elegir algunas específicas para el proyecto que tengamos por delante:

Lenguaje de programación: Esta será una elección que condicionará algunas de las herramientas que utilizaremos y el hecho de optar por un determinado lenguaje nos obligará a buscar y a encontrar librerías en ese lenguaje para resover las tareas del proyecto si no queremos reinventar la rueda.

En mi caso opto por Java por ser un lenguaje orientado a objetos, fuertemente tipado (esto tiene la ventaja de que el compilador nos ayuda a encontrar errores rápidamente en tiempo de compilación) y con un montón de librerías con licencia de código abierto o de software libre que podemos usar. En estos momentos Java tiene algunas carencias como el no disponer de closures (aunque muy posiblemente se añadan en la versión 8) pero para alguna tarea específica podemos utilizar Groovy (que es un lenguage de programación que puede ejecutarse sobre la JVM y si dispone de ellas).

Plataforma de desarrollo: Siendo este un blog con una temática entorno a software libre y Linux no podría elegir otra que no fuera el sistema del pingüino. Pero también hay motivos importantes por lo que lo recomendaría como tener a tu disposición un montón de software libre a un comando o unos cuantos clics de ratón para instalar y tenerlo actualizado. En windows pasado un tiempo se hace pesado y es una pérdida de tiempo el desinstalar el programa, buscar el instalador para la nueva versión y volverlo a instalar. Lo ideal sería que el proyecto pudiese ser desarrollado en cualquier plataforma y que cada persona eligiese con la que más cómodo se encontrase. Uno de los contras que tengo sensación es que al usar Arch Linux por una actualización en algún momento algo se «rompa» y me deje el sistema inutilizado.

IDE de desarrollo: Siendo Java el lenguaje de desarrollo por el que he optado como IDE optaría por eclipse. Aunque si necesitamos algo más liviano podríamos optar por Gedit directamente, emacs o vim. Una de las cosas importantes sería utilizar una que nos resalte la sintaxis de nuestro código fuente, soporte para hacer refactor o asistente de código.

Base de datos: En muchos proyectos necesitaremos persistir información y consultarla. Para resolver este asunto están las bases de datos, lo más probable sea que necesitemos una relacional y para ello tenemos MySql o PostgreSQL aunque en estos momentos las bases de datos orientadas a documentos están siendo muy nombradas como MongoDB, CrouchDB o Redis.

Herramienta de persistencia en base de datos: Entre los lenguajes de programación orientados a objetos y las bases de datos relacionales hay una discordancia en la forma de representar los datos. Para tratar de abstraernos del Sql que utilizan las bases de datos relacionales podemos utilizar un ORM que nos permitirá trabajar de una forma orientada a objetos además de abstraernos de la base de datos en concreto que utilizamos ya que aunque cada una implementa una especificación común de Sql hay ciertas diferencias entre ellas que deberemos tener en cuenta si no utilizamos un ORM. Uno de ellos es hibernate.

Framework de desarrollo web: Framework de desarrollo en Java hay para aburrir. De entre los que he usado en proyectos reales JSP, Struts, JSF, Grails y Tapestry me quedo con este último principalmente por poder desarrollar componentes y librerías de componentes que incluyen toda la funcionaliadad necesaria para que funcionen, que pueden ser reutilizados entre diferentes proyectos, que simplifica enormemente el desarrollo y es altamente extensible y adaptable a las necesidades que podamos tener en el proyecto.

Tomcat: es un contenedor de servlets y jsp «secillo» sobre el que desplegar nuestras aplicaciones web Java.

Framework Javascript: trabajar con javascript puede ser arduo más teniendo en cuenta que cada navegador tiene su propias peculiaridades por ello se hace casi imprescindible que en un proyecto web elegir un framework javascript que nos permita abstraernos de estas peculiaridades y nos simplifique el trabajo. Quizá uno de los más conocidos y utilizados sea jQuery aunque disponemos de otros como Prototype, Mootools aunque quizá menos usados y con menos plugins disponibles.

Otra serie de herramientas que quizá tengamos que tener en cuenta son:
JasperReports/iReport: generación de informes en varios formatos.
Lucene: indexación de datos.
JBoss: si necesitamos algo más completo que Tomcat prodíamos optar por servidor de aplicaciones como este.
Cherokee, Lighttpd, nginx: servidor web ligero y rápido.
jBPM: permite modelar flujos de trabajo de negocio.
Freemarker: herramienta para genergar archivos de texto basandose en plantillas.
Quartz: planificador de trabajos.
SLF4J y Logback: trazas de log.
Less: lenguaje para CSS.

Estas son las herramientas que seguramente elegiría para un proyecto web desarrollandolo con Java y que serán suficientes para la mayoría de proyectos web, si tuviese que elegir otra plataforma probablemente optaría por PHP y Symfony si el proyecto no es excesivamente complejo. Pero como digo hay muchas opciones y uno puede elegir la que más cómodo se encuentre desarrollando o considere más adecuada.

¿Alguna herramienta distinta de estas que tú consideres imprescincible o te haya gustado trabajar con ella?

viernes, 3 de junio de 2011

Libros de ciencia ficción y fantasía

Si te gustan los libros seguramente te hayas encontrado en algún momento que no encuentras uno determinado que te gustaría leer porque en las librerías comerciales ya están decatalogados o si los encuentras en alguna a través de internet están en inglés. En esta situación tienes varias posibilidades, una de ellas es hacerte con un lector de libros electrónico y buscarlo en formato digital en internet y si el libro es un poco conocido y no es la última novedad seguramente lo encuentres o si te gusta más leer en papel te puedes acercar a una biblioteca pública de tu ciudad.

Hace ya unos años descubrí el amplio catálogo de libros de las bibliotecas municipales de mi ciudad, he leido muchos libros que de otra forma no hubiese podido tener acceso a ellos, no están todos pero si muchos que he buscado, y estoy muy contento con esta opción ya que aparte de poder leerlos en papel no tengo que comprarlos con lo que eso me ahorro y luego además almacenarlos en casa además evito consumir papel con lo que ademas ayudo al medio ambiente, lo único que me cuesta es el tiempo de desplazarme y el transporte cada vez que quiera pedir o devolver uno, una vez prestados en el plazo de 45 días que los puedo poseer me leo las entre 250 y 350 páginas que suelen tener. He leido grandes libros de Isaac Asimov, Philip K. Dick, Arthur C. Clarke, Robert A. Heinlein, David Eddings y algún otro con los que he pasado muy buenos momentos. Todos estos autores tienen libros muy recomendables si te gusta el género de ciencia ficción y la fantasía y que entre sus libros han recibido varios premios Hugo y premios Nebula, que son un idicativo de libros que merecen la pena leer.

Entre los que he leido y recomiendo son (algunos son sagas de varios libros):
Y tengo una larga lista de libros esperando por leer y lectura para varios años. Hay muy buenos libros que han sido escritos hace ya varias décadas, si no sabes por donde empezar puedes busca una lista de los libros más recomendados además en los enlaces de referencia de más abajo seguro que encuentras más libros de estos autores y otros. La verdad es que se puede pensar en las bibliotecas como una forma de P2P fuera de internet, ¡úsalas! ¡aprovecha lo que comparten!.

¿Tienes algún libro en particular que te haya gustado del género de ciencia-ficción o fantasía?

Referencia:
http://epubgratis.me/
http://120linux.com/descargar-libros/
http://www.bibliotheka.org/
http://www.librostauro.com.ar/
http://www.quedelibros.com/
http://www.libroscienciaficcion.com/


http://ebook.online-convert.com/

viernes, 27 de mayo de 2011

Servidor web ligero Cherokee, instalación e integración con PHP en Arch Linux

Cherokee web server
El servidor web Cherokee es uno de los servidores de nueva generación llamados ligeros que mejora notablemente el rendimiento ofrecido por el más usado Apache HTTPD soportando más usuarios concurrentes, aceptando más peticiones por segundo y consumiendo menos memoria. Quizá no tenga toda la versatilidad de un servidor Apache HTTPD pero para la mayoría de los escenarios es más que suficiente. En el siguiente artículo vamos a ver cuales son sus principales características y como instalarlo junto con PHP en la distribución Arch Linux. Otros servidores similares a Cherokee son nginx y lighttpd que quizá te interese también echarles un vistazo. Por supuesto cherokee es un servidor con licencia GNU GPL v2 y por tanto es software libre.

Comencemos poniendo algunas de las características que soporta: FastCGI, SCGI, PHP, CGI, SSI, TLS y conexiones cifradas SSL, host virtuales, autenticación, codificación al vuelo, balanceo de carga, archivos de log compatibles con apache, balanceador de base de datos, actualizaciones sin parada del servicio, proxy HTTP inverso y mucho más.

De todas las características que posee Cherokee destacaría las siguientes:

- Actualizaciones sin parada del servicio que puede ser muy importante para algunos servicios que no pueden permitirse dejar de dar servicio ningún segundo.
- Configuración a través de una consola de administración accesible con el navegador esto no se si es una ventaja o desventaja ya que no sigue la filosofía de los sistemas Unix de realizar la configuración mediante un archivo de texto para hacer una restauración de la configuración en caso de que la perdamos pero sin duda hace que la configuración se realice más comodamente y es algo que no tienen otros servidores por lo que he considerado importante destacarlo. También podemos editarlo directamente aunque realmente no estaremos interesados en ello a menos que seamos un usuario avanzado.
- Cherokee Market con el que podremos instalar ciertos servicios de forma muy cómoda y con poca configuración, como por ejemplo, instalar un servicio de Drupal, Wordpress, phpBB, phpMyAdmin, nuxeo, Liferay y algunos otros.
- Host virtuales SSL con esta característica podemos usar SSL en host virtuales ya que cherokee hace uso del método Server Name Indication (SNI) por el que en la negociación de la sesión TLS se envía el nombre del host que se quiere acceder. Esta era una imitación importante al usar SSL en servidores virtuales basados en nombres.

Si esta características no te parecen importantes quizá la del rendimiento por si sola te parezca suficiente para empezar a utilizar cherokee, consulta las pruebas de rendimiento (en el apartado referencia) para ver en que medida mejora Cherokee el rendimiento respesto a otros servidores. Pero sin duda lo mejor sería que lo comprobases por ti mismo. Una nueva caracteristica añadida recientemente y que afecta al rendimiento es la llamada Font-Line cache. Los desarrolladores de cherokee se han dado cuenta que es muy habitual utilizar junto al servidor web otro servidor dedicado a cachear ciertos resultados, como Squid, sin tener que generar de nuevo el mismo contenido para cada petición, esto por si solo aumenta el rendimiento notablemente y reduce la carga del sistema pero aún asi hay cierta latencia y comunicación entre el servidor web y el servidor de cache que podría ser evitada como ha demostrado cherokee. Para reducir esta latencia cherokee incorpora en si mismo un servidor de cache que puede reducir esta latencia hasta en un 80%.

En Arch Linux la instalación de Cherokee es muy sencilla basta con:

# pacman -S cherokee

y se nos instalará la última versión disponible. Para arrancarlo y pararlo deberemos hacer:

# /etc/rc.d/cherokee start
# /etc/rc.d/cherokee stop

Si queremos que se inicie al arrancar el sistema deberemos añadirlo al apartado DAEMONS del archivo /etc/rc.conf (Consulta la wiki de Arch Linux para más detalles sobre como administrar los servicios):

# nano /etc/rc.conf

DAEMONS=(syslog-ng network netfs crond cherokee)

Para arrancar la consola de administración deberemos ejecutar:

# cherokee-admin -b -u


El parmámetro -b hará que cherokee escuche en cualquier dirección IP y no solo en 127.0.0.1. Y el parámetro -u hará que no se solicite contraseña al acceder a la consola de administración por lo que es recomendable no usarlo en un sistema de producción. En la pantalla de inicio de la consola de administración podemos ver información básica de la carga del servidor en cuanto a procesador y memoria y veremos si tenemos instalada la última versión de cherokee.

La consola de administración está dividida en varios apartados: Inicio, Mercado, Estado, General, vServers, Orígenes y Avanzado. En el apartado Market podremos instalar los servicios disponibles pero para ello previamente deberemos tener una cuenta de cherokee market. En el apatado General podemos modificar algunas característica generales del servidor. En el apartado vServers podemos administrar los servidores virtuales e instalar nuevos servidores virtuales, con el botón + podremos añadir fácilmente el soporte para PHP. En Avanzado podemos modificar algunos datos importantes sobre el funcionamiento del servidor.


Veamos ahora a ver como instalar PHP en cherokee. Primeramente instalaremos PHP con:

# pacman -S php php-cgi


Si todo ha ido correctamte podremos ejecutar:

$ php -v
$ php-cgi -v

Ahora procederemos crear un servidor virtual con soporte para PHP, vamos al apartado vServer y pulsamos sobre el botón +, seleccionamos Lenguages y PHP. Tal vez necesitemos crear un directorio con mkdir /var/www. Continuamos con el asistente y finalmente nos aparece en la lista de servidores el que acabamos de crear.


Ya nos queda poco!... solo nos queda crear un archivo php de ejemplo que lo crearemos con nuestro editor favorito en el directorio /var/www si hemos indicado este directorio en el asistente.


Espero que a alguien le entren ganas de usar este servidor web, si es así estaré encantado de escuchar sus comentarios.

Referencia:
http://www.cherokee-project.com/doc/basics_why_cherokee.html
http://www.cherokee-project.com/benchmarks.html
http://www.cherokee-project.com/doc/other_goodies.html
http://www.cherokee-project.com/doc/other_graphs.html
http://www.cherokee-project.com/doc/cookbook_php.html

http://www.redes-linux.com/manuales/Servidor_web/ponencia_cherokee.pdf
http://en.wikipedia.org/wiki/Cherokee_(webserver)
http://www.youtube.com/watch?v=bIxFzOv3U1A

https://wiki.archlinux.org/index.php/Daemon

viernes, 20 de mayo de 2011

Guías de instalación Arch Linux actualizadas

 Arch Linux es una distribución rolling release y como tal en constante actualización de sus paquetes. Por ello los manuales o guías de instalación de Arch Linux pueden quedar desactaulizadas en alguna de sus secciones si no son actualizadas cada cierto tiempo. A la hora de instalarlo es recomendable además leer las guías de la propia wiki de Arch Linux ya que en ella la información suele estar actualizada.

Ya hacia un tiempo que no actualizaba las guías de instalación que tengo en mi blog y a pesar de que he ido modificándolas algunas imágenes se habían quedado obsoletas. Hoy les he dado un repaso más a fondo siendo estos los puntos que he modificado:
  • Como de grabar la imagen USB de instalación (dd o UNetbootin y desde Windows).
  • Particiones a crear en el disco durante la instalación base.
  • Instalar GRUB 2 durante el sistema base en una única partición Ext4.
  • Apartado actualizado sobre Gnome 3.
  • Añadidas algunas nuevos programas a la lista de los más comunes.
  • Actualización de las imágenes de las guías e incorporación en ellas de marcas de agua.
  • Y otras pequeñas modificaciones que he ido haciendo desde que las cree.
Las guías están disponibles en los siguientes enlaces:

Espero que sean útiles para alguien que pretenda instalar Arch Linux en una máquina virtual o directamente sobre el metal. ¡A disfrutarlas!

martes, 17 de mayo de 2011

Añadir marcas de agua a imágenes con ImageMagick

ImageMagick es una librería con un conjunto de utilidades que permiten manipular imágenes a través de la linea de comandos aunque también tiene librerías para usarlo desde los lenguajes de programación más conocidos (Java, .NET, Python, C, C++, PHP, ...) y tiene binarios para Windows, Linux y Mac. Mediante estas utilidades se pueden añadir marcas de agua a las imágenes entre otras muchas cosas, a decir verdad, prácticamente se puede hacer muchas de las cosas que una herramienta de retoque fotográfico puede pero a través de la linea de comandos o como decía desde alguno de los lenguajes para el que tenga «bindings» y con la posibilidad de automatizar el proceso. Las marcas de agua consisten en aplicar un patrón o estampado a una imagen, pueden ser muy visibles, pasar prácticamente desapercibidas o estar ocultas sirviendo para:

- Anotar sobre la imagen alguna información.
- Resaltar algún aspecto de la imagen.
- Añadir derechos de autor o logos como una forma de proteción anticopia.

Una buena marca de agua tiene que tener las siguientes características:

- La marca de agua debería ser visible (si la marca de agua no está oculta) independientemente de si la imagen es clara u oscura.
- Debería ser difícil de eliminar de la imagen.
- No debería ser muy molesta para los usuarios.

¿En que situación práctica querriamos añadir marcas de agua? Pues una de ellas es si tenéis un blog quizá en algún momento habéis pasado por la situación de que alguna página os ha copiado el contenido de alguna entrada, hay páginas que se dedican exclusivamente a actuar como directorios o como agregadores de contenido en los que a veces ni siguiera ponen un enlace a la fuente original. Por mucha licencia de uso que tengamos en nuestro blog el que nos copien el contenido no lo podemos evitar pero si podemos añadir marcas de agua a las imagenes para al menos que se identifique el origen de las mismas.

Con los siguientes comandos crearemos una marca de agua con un texto, repartido por toda la imagen o posicionado al sudeste de la imagen:

$ convert -size 700x370 xc:none -family Cantarell -fill white -colorize 40 -gravity NorthWest -draw "text 10,100 '(CC) BY-NC-SA http://elblogdepicodev.blogspot.com'" -gravity SouthEast -draw "text 10,100 '(CC) BY-NC-SA http://elblogdepicodev.blogspot.com'" watermark.png
$ composite -tile -dissolve 20 watermark.png imagen.jpg imagen-watermark.jpg
$ composite -gravity SouthEast -dissolve 20 watermark.png imagen.jpg imagen-watermark.jpg

Con el primer comando creamos la imagen de marca de agua con un texto pero también la podemos crear con alguna otra herramienta como Gimp, al final la marca de agua es una imagen y la podemos obtener por cualquier medio no hace falta que la generemos con ImageMagick. En el segundo aplicamos la marca de agua en forma de embaldosamiento a toda la imagen en la que la queremos incluir. En el tercero aplicamos la marca de agua en el sudeste de la imagen.

Si estamos añadiendo la misma marca de agua a muchas imágenes necesitaremos automatizar el proceso para que las marcas de agua se apliquen de la misma forma y queden todas igual, también para tardar prácticamente nada de tiempo en hacerlo comparado con una herramienta de retoque fotográfico evitando además un proceso que es aburrido, repetitivo y manual. En Linux lo podemos hacer de la siguiente forma que busca todas las imágenes que su nombre cumpla el patrón imagen*.png y ejecuta el comando composite para cada una de ellas:

find . -name "imagen*.png" -type f -exec composite -gravity SouthEast -dissolve 20 watermark.png {} {} \;

La cantidad de posibilidades que ofrecen estas herramientas de ImageMagick a través de sus numerosos parámetros y opciones puede llegar a ser abrumadora por lo que es recomendable encontrar algún ejemplo con lo que necesitemos hacer o partir de algo similar al resultado final que queramos.

En el siguiente ejemplo puedes ver el resultado de aplicar una marca de agua a una imagen posicionándola en el sudeste de la imagen original usando el último comando composite de los ejemplos.

+
+
Image Magick
=
 

Otro asunto relacionado con automatizar tareas con ImageMagick es cambiar el formato, tamaño o realizar escalado de forma masiva a muchas imágenes.

Referencia:
ImageMagick
ImageMagick Watermarking
Convertir imágenes entre formatos y cambiar tamaño con ImageMagick